 灵页 LingSlide
这次实测验证了什么?
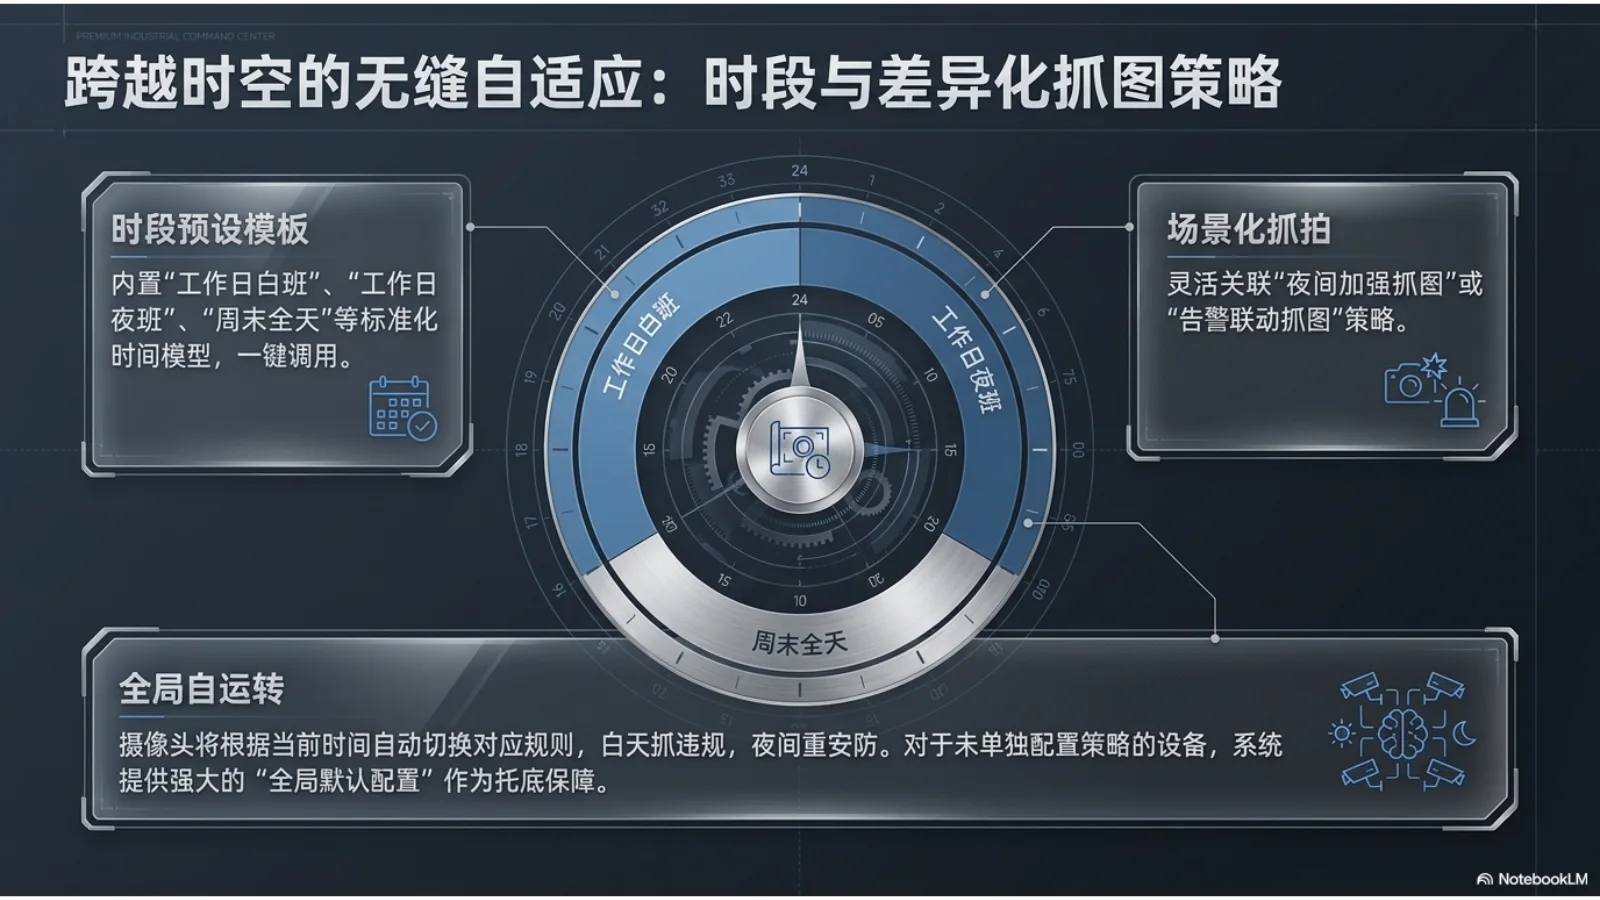
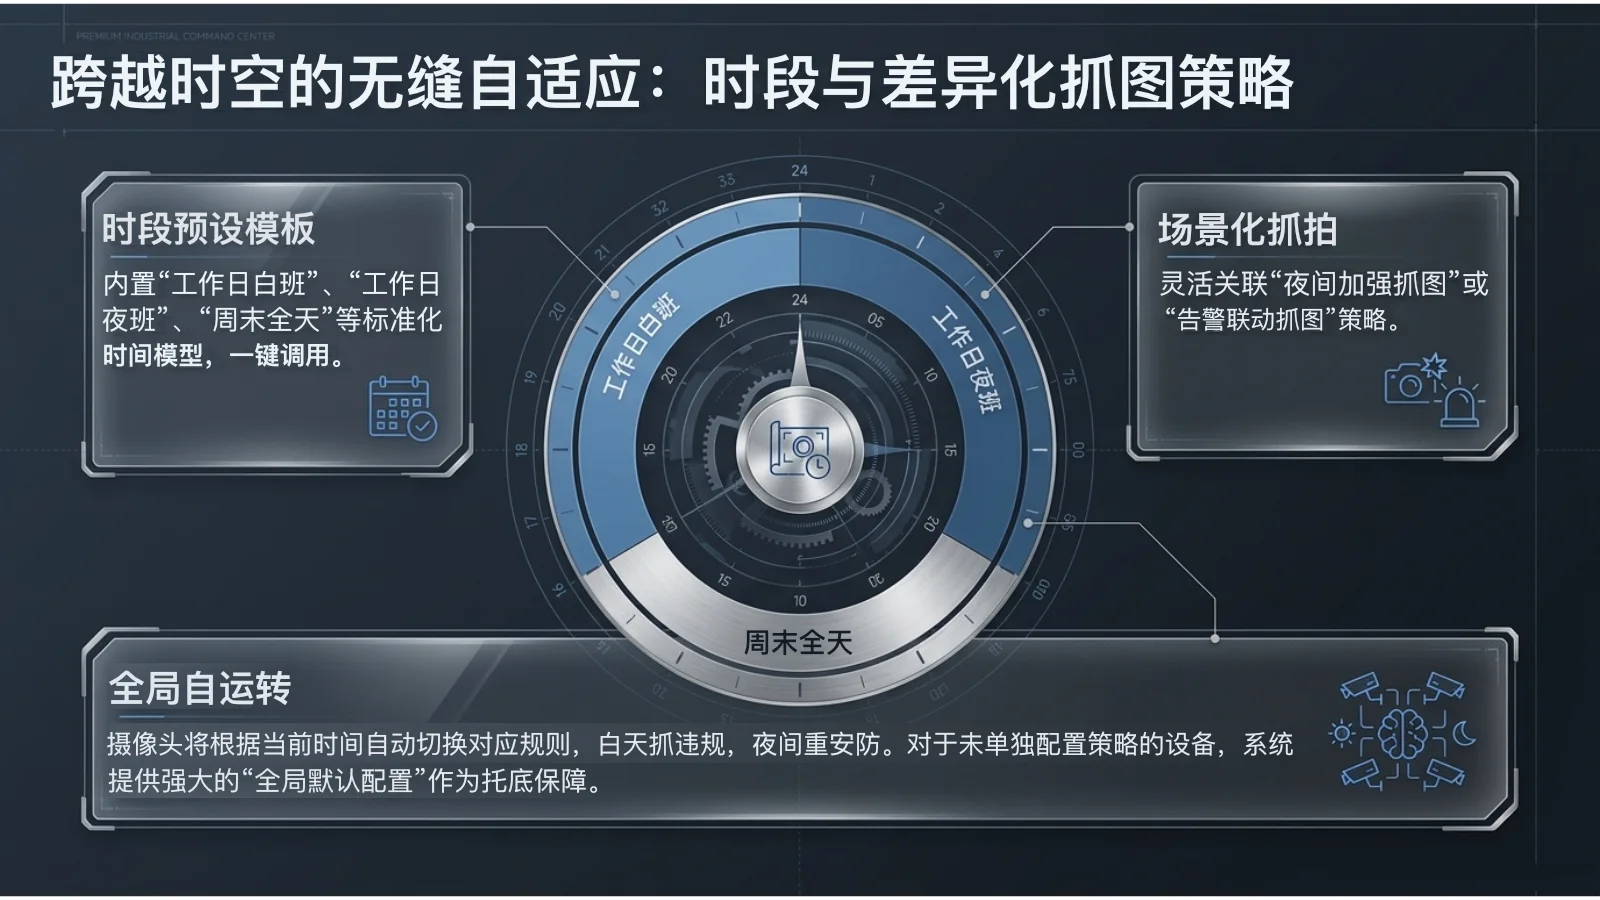
验证目标不是追求一个漂亮的“准确率”,而是确认通用流程能否处理完整文件。样例来自一份 15 页 NotebookLM 图片型演示稿,每页原始结构都是一张整页 RGB 图片,没有可直接提取的正文文本。
流程使用统一规则识别文字区域、判断哪些内容适合重建、生成清理后的背景,再写入 PowerPoint 文本框。生产规则不包含页码、固定区域 ID、样例文案或预设颜色特判。
当前已确认的数据是什么?
| 检查项 | 当前结果 | 解释边界 |
|---|---|---|
| 样本规模 | 1 份文件,15 页 | 控制样例,不代表不同用户文件分布 |
| 识别区域 | 402 个 OCR 区域 | 区域数不等于全部都应转成文本框 |
| 可编辑语义层 | 206 个文本框 | 标题、正文和关键语义文字优先 |
| 保留视觉层 | 196 个区域 | 装饰、小字、复杂图形和非水平标签优先保真 |
| 渲染检查 | 15/15 页完成全尺寸渲染 | 确认文件可渲染,不等于所有文字语义都正确 |
| 自动测试 | 33/33 项通过 | 覆盖现有规则回归,不替代真实用户验收 |
为什么不公布一个“99% 准确率”?
因为单一样本无法代表 NotebookLM 用户的全部主题、字体、语言和视觉风格。OCR 接口返回的置信度,也不等于与人工真值逐字比对后的字符准确率。把内部置信度包装成市场准确率,会掩盖数字、专有名词和低对比度文字的真实风险。
当前结果只能证明:在这份控制样例上,完整 15 页能够按照统一规则完成文字分层和渲染。它不能证明每位用户都能获得同样结果,也不能证明无需人工核对。
哪些风险仍待验证?
- 更多中文字体、深色背景、信息图和小字号页面;
- Windows PowerPoint、Mac PowerPoint 与 WPS 的字体和版式差异;
- 真实用户是否会完成导出,并在 2~30 天内再次使用;
- 处理失败率、人工修改时间和每份文件的 OCR 成本。
下一轮 10 份真实文件怎样评估?
下一轮不会只记录“成功或失败”,而是为每份文件保存同一组字段:来源场景、页数、识别区域、可编辑文本框、待确认数、处理耗时、导出结果、用户修改次数和反馈。脱敏前不公开文件内容,熟人测试和自然用户样本分别统计。
- 样本必须是用户原本就需要修改的真实 NotebookLM 演示稿。
- 记录从进入页面到成功导出的完整漏斗,不把浏览量当作使用。
- 对关键数字和专有名词进行人工核对,保留修改前后记录。
- 样本不足时报告原始人数和文件数,不输出稳定转化率。